
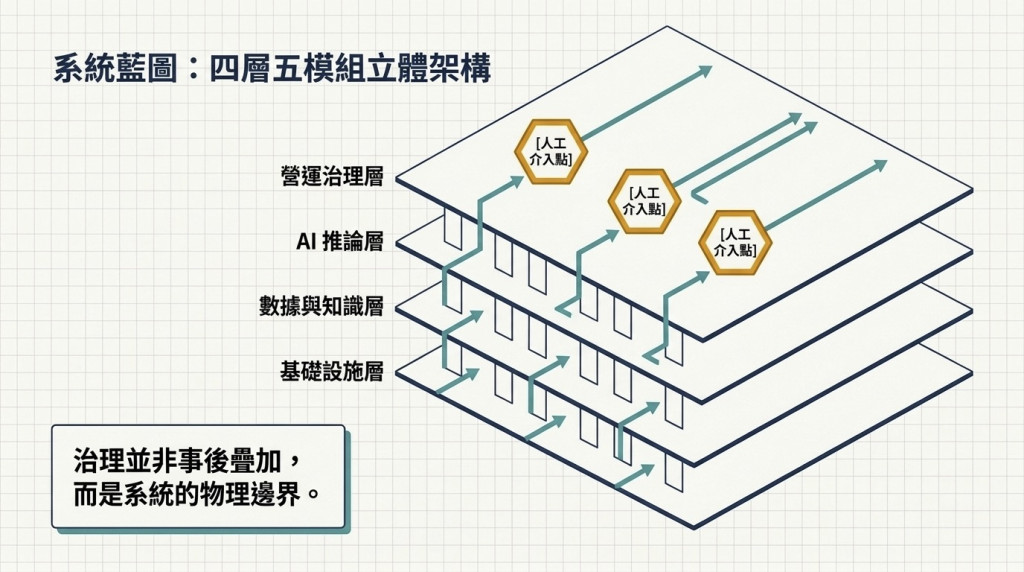
在金融科技的浪潮中,許多組織最常踩到的坑,就是讓 AI 助理如野草般散落在各個業務流程,卻缺乏統一的監控、驗收與管理機制。三十天前,銀保營運系統(BAIOS)面對的是一個典型的難題:「零散的 AI 助理,怎麼變成一套可管理的營運系統?」
這是一段充滿挑戰的旅程。身為一名長期觀察 AI 治理的專家,我見證了這套系統從最初的混亂,透過不斷的實測與修正,最終收官成為具備「四層架構、五個執行模組、四項核心 AI 任務」的營運中台。支撐這套架構的是 250 個扎實的測試案例。這種從 30 天實戰中留下的「傷疤」,才是 AI 落地實務中最珍貴的資產。在金融業,透明度與治理從來不只是流行語,而是生存的本能。
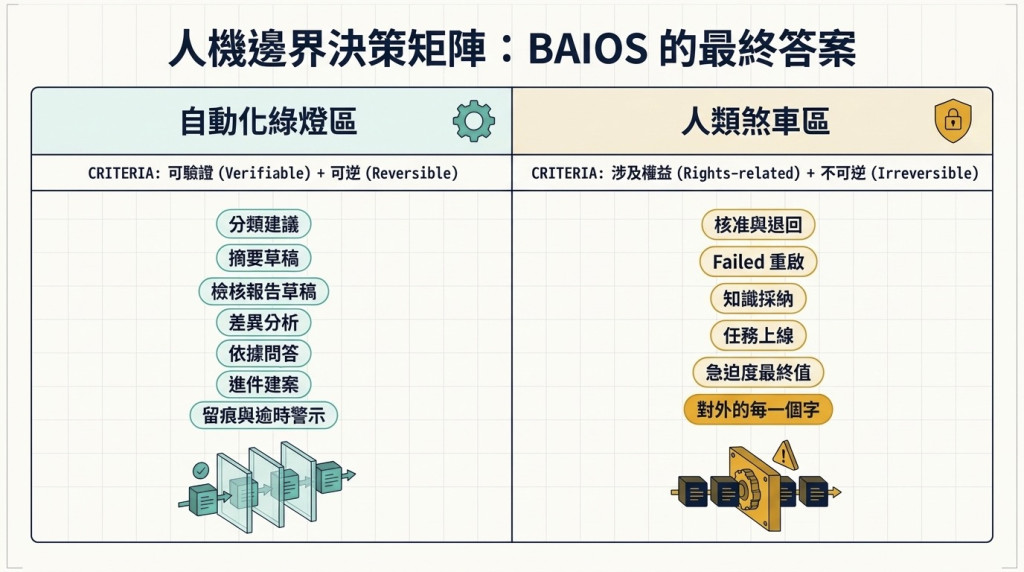
在 BAIOS 的治理哲學中,自動化與人工介入的邊界絕非模糊地帶,而是基於風險權衡的精確切割。
可以自動化 (Automation):
仍須由人決定 (Human Decision):
> 所有的治理機制,本質上都在守住這條線。
當 AI 處理的是內部分析與草稿生成時,我們可以依賴技術提升效率;但當決策涉及對外的最終承諾或權益變更時,人類的責任絕不能缺席。
在 AI 專案中,開發者最容易陷入「自我感覺良好」的陷阱。為了打破這種幻覺,BAIOS 堅持一項硬派的原則:不用記憶背書,要用程式走查。
這正是 程式化總驗收 (final_acceptance.py) 的價值所在。在金融業的營運邏輯下,宣稱具備功能是沒用的,你必須提供「grep 得到的證據」。驗收腳本會直接讀取資料庫與紀錄檔,針對 12 項關鍵指標進行無情的勾稽,包括:
這種以程式為準的驗收方式,確保了 AI 系統的每一項輸出都是有跡可循的,而非僅憑開發者的口頭承諾。
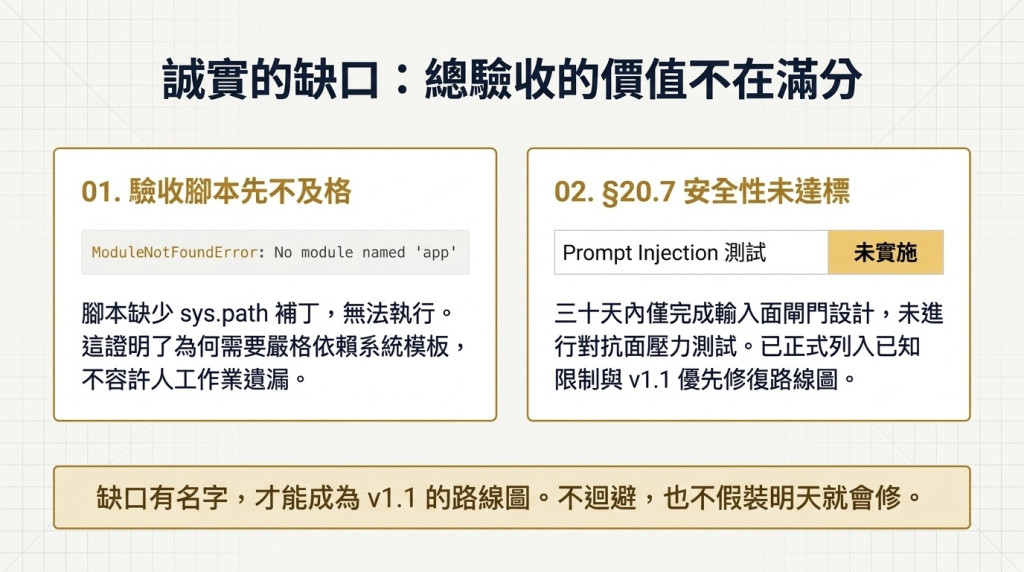
在 BAIOS 的最後一哩路中,我們誠實地紀錄了兩個失敗案例,這才是專業治理的表現。
首先是基礎環境的疏失:總驗收腳本在第一次執行時就因為路徑錯誤(ModuleNotFoundError: No module named 'app')而崩潰。這再次證明了為何「程式化驗收」比人工檢查更可靠——它不會因為你寫了三十天腳本的經驗就對錯誤產生免疫。
其次是更深層的治理透明度:在編寫「AI 可解釋性報告」時,我們在 第 20.7 節 關於 Prompt Injection 測試的欄位中,誠實地填上了「未實施」。儘管系統在輸入端已設有閘門、掃描與遮罩,但尚未完成對抗面測試。
「總驗收的價值不在滿分,在於缺口有名字。」 透過不迴避、不假裝的透明度,將已知限制明確列入未來的 v1.1 路線圖,這才是 AI 專案能真正被企業信任的關鍵。
為了讓這 30 天的經驗能夠被複製,我們提煉出一份包含 28 條規則的「AI 導入檢核表」。這不是憑空想像的理論,而是每一條都標註了 「Origin Day」 出處的實戰紀錄。
這份清單揭示了 AI 系統生命週期管理的重要性,特別是:
AI 進入金融營運領域,本質上是一個「紀律」問題而非「技術」問題。BAIOS v1.0 留給讀者最核心的觀點是:「每個 0 都說得出自己是哪一種 0」。
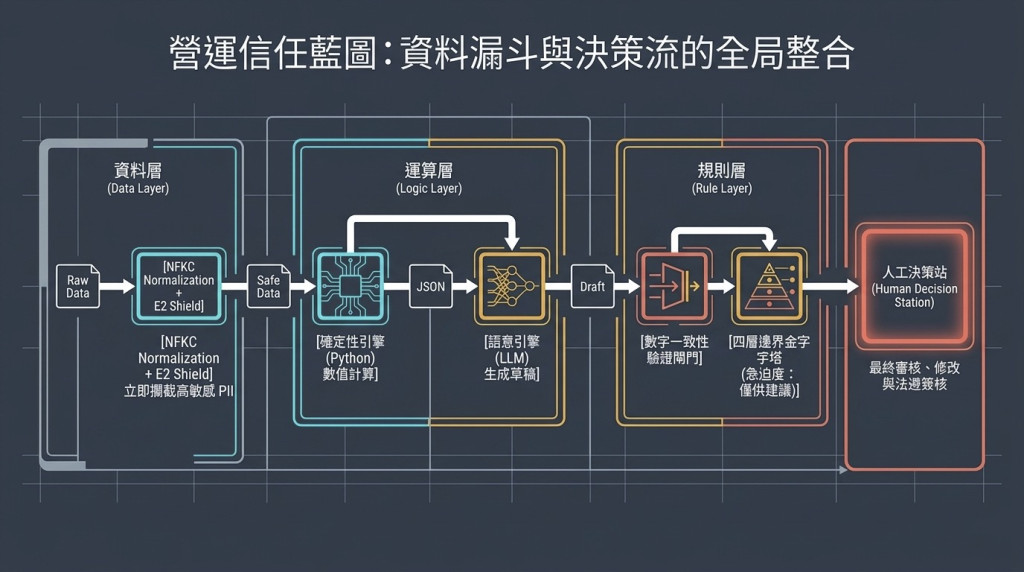
這句話的背後,代表的是一種極致的透明度——即便是失敗的紀錄、空缺的數值,都必須有明確的原因與日誌支撐。AI 的角色應該是「先找到依據,再執行任務」,並在低風險領域極大化效率,在高風險領域保留人類決策的最終防線。
當 AI 帶來的效率與人類應負的責任發生衝突時,你的組織是否已經準備好那條「不可跨越的線」?


 iThome鐵人賽
 看影片追技術